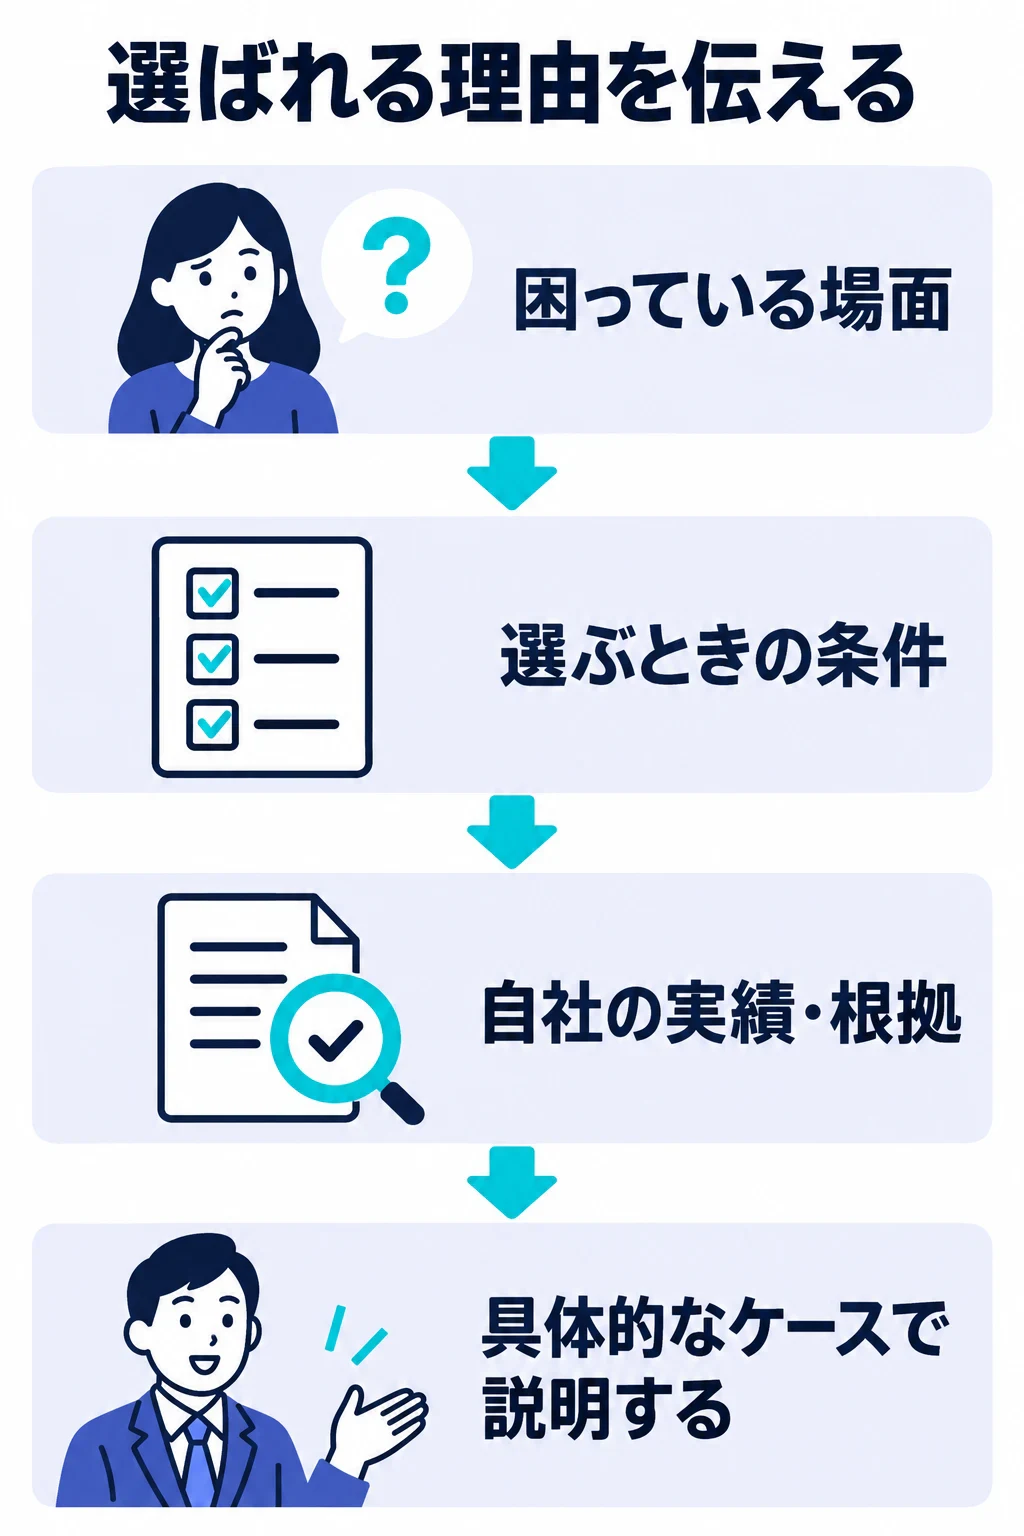
最近、私自身、何かを調べるときに、まずGPTへ聞くことがかなり増えました。
ランニングシューズを買うときもそうですし、「この辺でおすすめのお店は?」「こういう条件ならどこがいい?」のようなことも普通に聞きます。
しかも、単に「おすすめを教えて」と聞くのではなく、自分の状況や好み、予算、やりたいことを一緒に伝えます。すると、その条件を踏まえて候補と理由を返してくれます。
考えてみると、企業選びでも同じことが起きています。
実際、Beekleへ生成AI経由で問い合わせたお客様へ流入経路を聞いた時も、これまで聞いた範囲では似た行動が繰り返されていました。
会社名や「AI開発会社」という単語だけで探したのではなく、自分たちの状況と、やりたいことを生成AIへ説明し、その条件で候補としてBeekleを勧められて問い合わせた。
この購買行動を見ると、LLMOで何をすべきかはかなり単純に見えてきます。
「こういう状況の顧客には、なぜうちが向いているのか」を分かるように説明し、その説明を信じられる証拠を公開する。
難しい言葉を使えばCEP、KBF、RTBですが、結局やることはこれです。
AI検索では、ユーザーが最初から「状況」を入力する
従来の検索では、「AI開発会社 おすすめ」「ランニングシューズ おすすめ」のような比較的短いキーワードから情報収集を始めることが多くありました。
生成AIでは、最初から自然文で条件を書けます。
- 何に困っているか
- 何を実現したいか
- 予算はいくらか
- どんな制約があるか
- 何を重視しているか
- すでに何を試したか
AI検索の回答生成は、大まかに「推論・調査・生成」の3段階に整理できます。私たちは、企業側の実務を「CEP(状況) → KBF(重要購買決定要因) → 参照先 → RTB(根拠)」の順で考えています。
また、RAGの原論文では、事前学習モデルが内部に持つ知識と、外部から取得した情報を組み合わせて回答する構成が示されています。IRCoTやFLAREでは、複雑な質問に対して途中の文脈に応じて追加の情報取得を行う方式も研究されています。
各商用サービスの内部実装がすべて公開されているわけではありませんが、少なくとも、ユーザーの問いを起点に、必要な観点や情報を集め、理由付きの回答を作るという方向は公開研究と各社の説明から確認できます。
マーケティングの言葉に直すと、CEP・KBF・RTBになる
ここまでの技術の話を、経営やマーケティングの観点で考えるとかなり単純です。
誰の、どんな課題に対して、何が重要で、自社はどう解決し、何がその証拠なのか。
これを分けると、次の三つになります。
- CEP(Category Entry Point):どんな状況・課題・目的で相談されたいか
- KBF(Key Buying Factor):その状況では、何を重視して選ぶべきか
- RTB(Reason To Believe):なぜ自社がその基準を満たすと信じられるのか
そして、自社の商品、技術、仕事の進め方は、KBFに対する「自社の回答」です。
だからLLMOでやることは、AI向けの特殊な文章を書くことではありません。
どの状況で、何を理由に選ばれたいのか。その理由を裏付ける証拠は何か。
ここを揃えることです。
研究をマーケティングへ翻訳すると、文書単位でCEP・KBF・RTBをそろえる
2026年のFeatGEO研究は、生成AIによる引用可視性を最適化する際、孤立した語句の書き換えよりも、文書レベルの内容特性の方が引用挙動へ強く影響したと報告しています。
同じく2026年のMind Reader研究は、検索クエリの背後にある潜在的なユーザー需要を抽出し、その需要に対して回答に必要な推論情報をコンテンツ側でカバーすることで、生成検索内の可視性を高める方法を示しています。
これらの論文がCEP、KBF、RTBというマーケティング用語を使っているわけではありません。ただ、実務へ翻訳するとかなり分かりやすい。
一つの文書の中で、ユーザーがどんな状況にいるのか(CEP)、その状況では何を重視すべきか(KBF)、なぜ自社がその条件を満たせるのか(RTB)を、一つの論理としてそろえる。
ということです。
つまり、「一つの事実を一つのチャンクへ切る」のではなく、ユーザーの問いに答えるために必要な判断材料を、文書全体として不足なく持たせる方が研究の方向性にも近いと考えます。
もちろん、「必ず一つのCEPにつき一ページにしなければならない」と研究が証明したわけではありません。ただ、課題だけ別ページ、比較基準だけ別ページ、証拠だけ別ページへばらばらに置くより、その購買状況について読む文書の中で「なぜこの会社なのか」まで論理がつながっている方が、読者にもAIにも理解しやすい設計です。
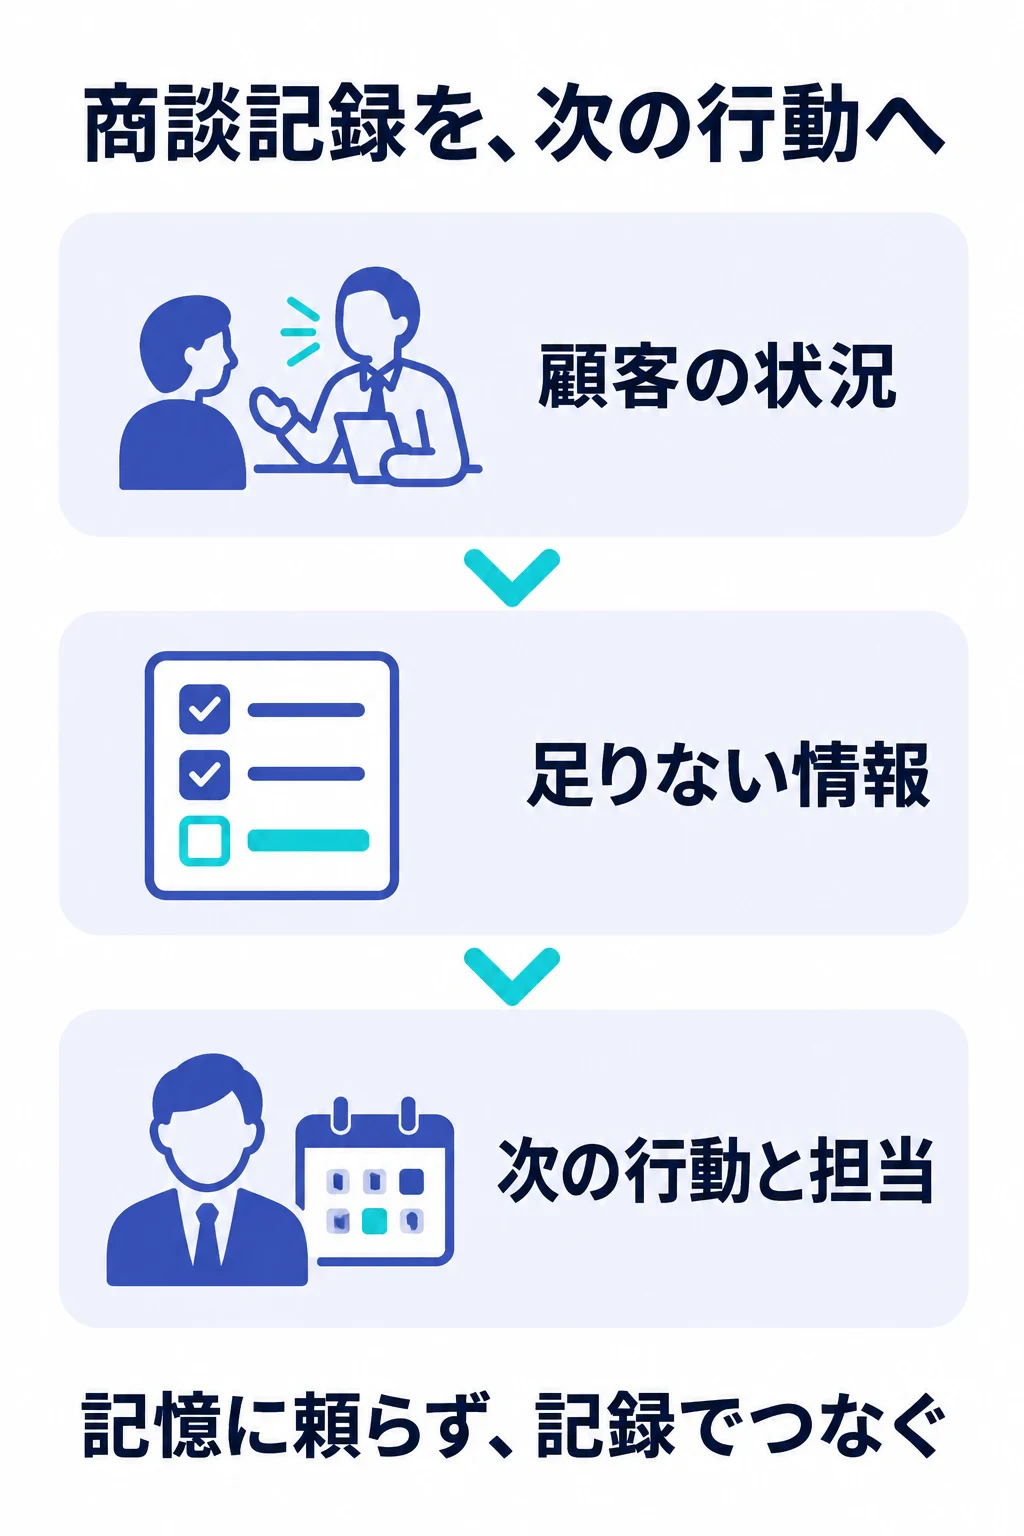
実際のお客様の行動を見ると、この説明がかなり腑に落ちる
Beekleへ生成AI経由で問い合わせたお客様に流入経路を確認すると、これまで聞いた範囲では、会社名を最初から知っていて指名したというより、まず自分たちの状況とやりたいことをAIへ相談し、その回答の中でBeekleを知ったというケースが続いています。
これは従来の検索キーワードより、かなりCEPに近い入力です。
たとえば、
AIを導入したいが、何から作るべきか分からない。既存システムがあり、社内に専門家は少ない。小さく試してから本番化したい。
と相談したとします。
この状況では、要件整理、既存システムとの接続、PoCから本番までの進め方、評価方法、運用、似た条件の実績などが比較材料になり得ます。
これがKBFです。
そして企業側には、そのKBFを満たすと説明できるRTBが必要です。
- 具体的な事例
- 対象・期間・条件が分かる実績数値
- 顧客のコメント
- 実際の画面やデモ
- 設計やテストの証跡
- 第三者媒体からの言及
- 向いていない条件や限界
AIが比較しやすいように言葉を飾るのではなく、比較に必要な事実を用意する。この方が効きます。
この内容について、Beekleに相談してみませんか? 何を作るべきか、どこまで費用をかけるべきか、発注前の不安を無料で整理します。チャンキングをLLMO施策としてやる必要はない
私はRAGを実装する側でもあるので、この話にはかなり違和感があります。
自分でRAGを作ると分かりますが、チャンキングは基本的に情報を取得する側のアルゴリズムで行う処理です。HTMLや文書を取り込み、見出しや段落、文などを見ながら、検索やコンテキスト投入に都合のよい単位へ分割する。必要ならオーバーラップさせたり、別の粒度で索引を作ったりする。これは検索基盤側が、自分のモデルや検索方式に合わせて決めることです。
つまり、公開する側が「相手のAIがこう分割するかもしれない」と想像して、文章を300文字ごと、500文字ごとに切る必要はありません。取得側は、公開側が何も意識しなくても必要に応じて勝手に分割・解析します。
Googleも2026年に公開した生成AI検索向けの公式ガイドで、「Chunking content」はGoogle Search向けには無視してよい施策の一つとして明示しています。Googleは、AIに理解させるためにコンテンツを小さな断片へ分割する必要はなく、同じページに複数の話題があってもシステム側でニュアンスを理解し、関連する部分をユーザーへ示せると説明しています。また、理想的なページ長もないとしています。
Google Searchには、Webページ内の個別のセクションやpassageを識別して、ページの関連性を理解する「Passage ranking system」もあります。
さらに、AI OverviewsやAI Mode向けに、新しいAI用テキストファイル、特別なマークアップ、専用の構造化データを作る必要もないとGoogleは説明しています。
つまり、Webサイト運営者が考えるべきことは、Googleや生成AIが内部でどう文章を分割するかを先回りして再現することではありません。
読者にとって分かりやすく、価値があり、その文書の中でCEP・KBF・RTBの論理と証拠がつながっている情報を書く。
Google自身も、生成AI検索で最も重視すべき方向として、独自性があり、役立ち、信頼できるpeople-firstなコンテンツを挙げています。
見出しや段落は、人間が読みやすくするために普通に整理すればよい。AI向けの固定文字数へ切るために設計する必要はありません。
これは結局、信頼形成のブランディングだと思う
ブランドは、名前を覚えてもらうことだけではありません。
ブランド想起の研究では、ブランド・セイリエンスは、購買状況でそのブランドが思い出される傾向として捉えられています。
また、ブランド・クレディビリティの研究では、信頼性と専門性が、比較候補に入ることや、候補の中から選ばれることと関係することが示されています。
人間向けに言えば、
「こういう時なら、この会社が良さそう。なぜなら、こういう強みがあり、実績もあるから」
という状態を作るのがブランドです。
AI検索では、この関係をAIが参照できる公開情報としても持つ必要があります。
CEP × KBF × RTB = 特定の状況で、理由と証拠を伴って選ばれるブランド
なので私は、LLMOはSEOの技術的な追加施策というより、AIが介在する購買行動に合わせた信頼形成とポジショニングの話だと思っています。
E-E-A-Tも、RTBの信頼性を支えるものとして考えると分かりやすい
Googleは、有用で信頼できるコンテンツを考える観点として、Experience、Expertise、Authoritativeness、Trustworthinessを挙げています。
LLMOへ当てはめるなら、
- CEP:どの状況で候補になるか
- KBF:その状況で何を重視するか
- RTB:自社がその基準を満たす証拠
- E-E-A-T:その証拠や発信者を信頼できるか
という整理が分かりやすいです。
実際にその仕事を経験した人が書いている。専門的に妥当である。第三者からも確認できる。数字の定義が明確である。条件や限界も隠していない。
こうした情報があるほど、RTBは単なる自称ではなくなります。
結局、難しいことは置いておいて「なぜこのケースではうちがいいのか」を説明すればいい
ここまでRAG、GEO、CEP、KBF、RTB、E-E-A-Tと色々書いてきました。
ただ、経営者やマーケターがAI検索の内部アルゴリズムを細部まで理解する必要はないと思います。
Google自身も、生成AI検索向けの小手先のハックより、ユーザーにとって有用で独自性のある情報へ集中するよう案内しています。
であれば、企業側がやることもかなり単純です。
「こういう状況の顧客には、なぜうちが向いているのか」を正直に説明し、その説明を信じられる証拠を出す。
「技術力があります」「伴走します」「実績多数です」と言うだけではなく、
この状況では、この点が重要です。
当社は、こういう方法で対応します。
実際に、この事例とこの数字があります。
ただし、この条件には向きません。
まで公開する。
マーケティング用語に直せば、CEP、KBF、RTBです。
私自身の買い物でも、実際のお客様の流入でも、すでに「状況をAIへ相談し、候補と理由を受け取る」という行動が起きています。
だからLLMOは、未来のSEOの話ではなく、すでに現在の顧客接点の話です。
そして最終的には、AIを攻略することより、自社がなぜ選ばれるべきかを、顧客とAIの両方に理解できる形で説明することに戻るのだと思います。
参考資料
- 株式会社LANY『LLMO白書―AI時代の新たなマーケティング戦略』
- Lewis et al.(2020)Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Trivedi et al.(2023)Interleaving Retrieval with Chain-of-Thought Reasoning for Knowledge-Intensive Multi-Step Questions
- Jiang et al.(2023)Active Retrieval Augmented Generation
- Aggarwal et al.(2024)GEO: Generative Engine Optimization
- Liu & Xu(2026)Think Before Writing: Feature-Level Multi-Objective Optimization for Generative Citation Visibility
- Chen et al.(2026)Mind Reader: Latent User Demand-Guided Content Optimization for Generative Search Engine
- Romaniuk & Sharp(2004)Conceptualizing and Measuring Brand Salience
- Erdem & Swait(2004)Brand Credibility, Brand Consideration, and Choice
- Google Search Central「Optimizing your website for generative AI features on Google Search」
- Google Search Central「A guide to Google Search ranking systems」
- Google Search Central「Creating helpful, reliable, people-first content」