良いサービスを提供しているのに、新しい顧客から問い合わせが来ない。
紹介なら受注できる。商談まで進めば評価も悪くない。しかし、自社を知らない顧客が自社を見つけ、比較候補に入れるまでの流れが弱い。
この場合、商品力や営業力だけが問題とは限りません。
顧客がどんな状況で相談し、何を基準に比較し、なぜ自社を信じてよいのかという「選ばれる論理」が、公開情報としてつながっていません。
AI検索は、ページを探すだけでなく、比較理由まで組み立てる
生成AIを使った検索では、ユーザーが状況、目的、予算、制約を自然文で伝えます。
Googleも、AI ModeやAI Overviewsでは複数の関連検索を行う「query fan-out」を使う場合があり、複雑な比較や探索を支援すると説明しています。
RAGの原論文でも、モデル内部に持つ知識と、外部から取得した情報を組み合わせて回答する構成が示されています。
各サービスの内部実装は同じではありませんが、ユーザーの問いを起点に、必要な情報を集め、比較し、理由付きの回答を作る方向は確認できます。
「誰の、どんな課題に、どう応えるか」はCEP・KBF・RTBで整理できる
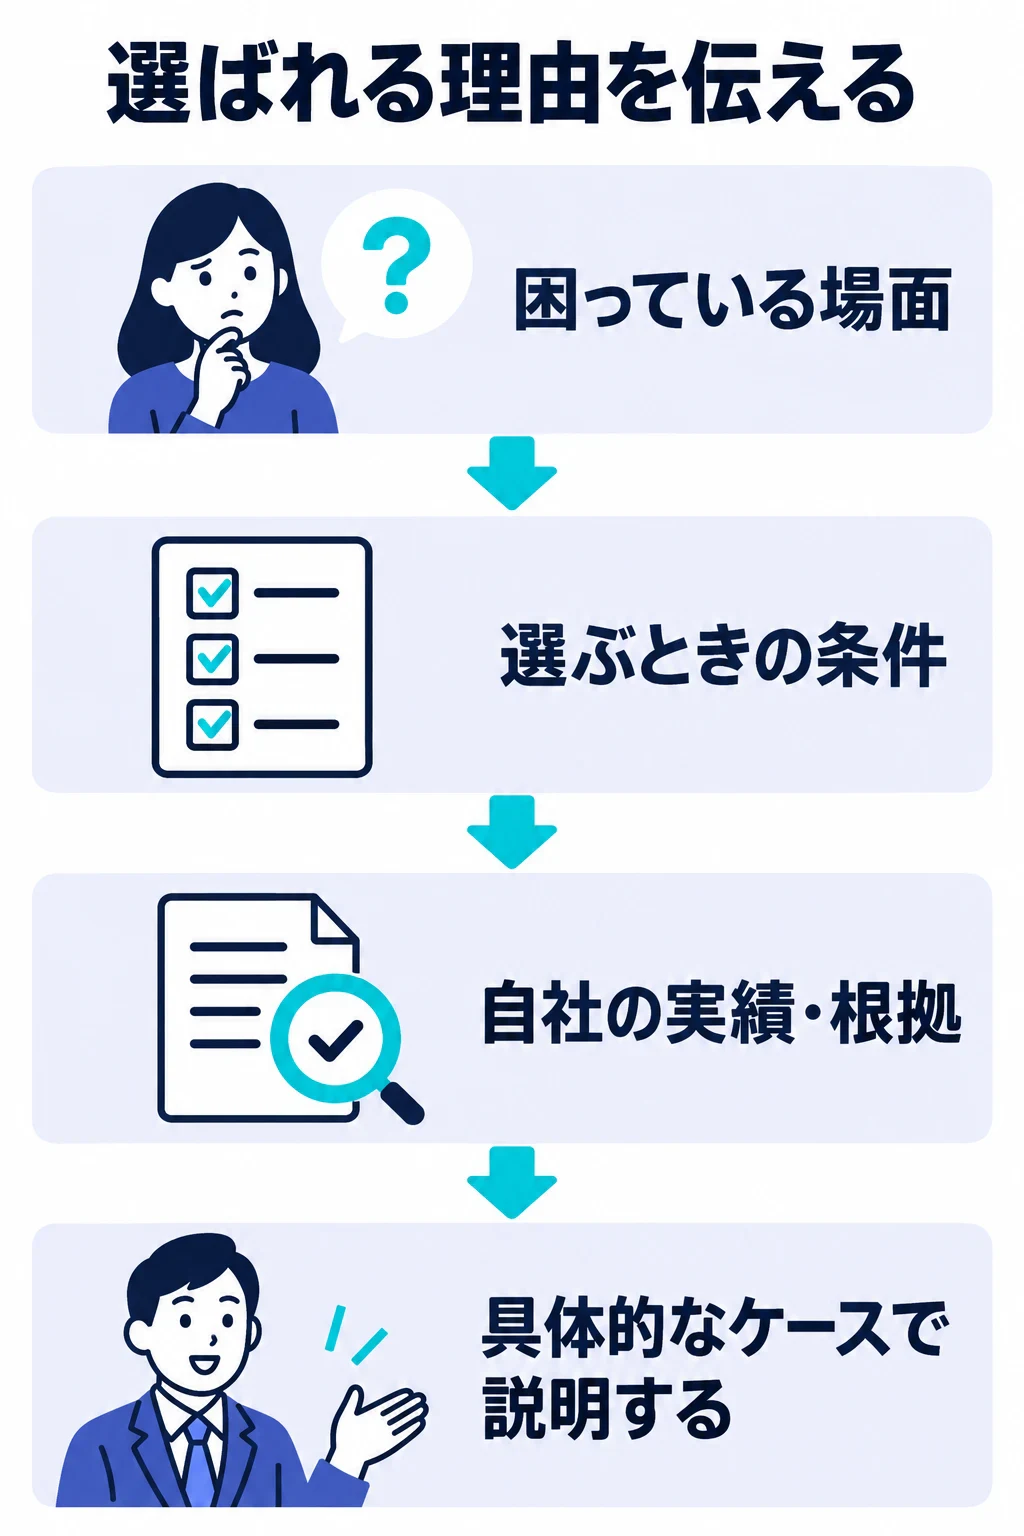
誰の、どんな課題に対して、何が重要で、自社はどう解決し、何がその証拠なのか。
LLMOの文脈で言えば、これはほぼCEP・KBF・RTBです。
- CEP:どんな状況・課題・目的で相談されたいか
- KBF:その状況で何を重視して選ぶべきか
- 自社の回答:どの能力・商品・仕組みでKBFを満たすか
- RTB:なぜその主張を信じられるか
LANYの『LLMO白書』でも、実務フレームを「CEP → KBF → 参照先 → RTB」の順で整理しています。
だから、会社名やサービス名を繰り返すだけでは足りません。
この顧客には、この課題がある。
この課題では、この比較基準が重要である。
自社は、この能力と仕組みによって基準を満たす。
その証拠は、この事例、数値、画面、顧客評価である。
ただし、この条件には向かない。
この論理を公開情報として整えることが重要です。
研究から見ると、文書全体で「選ばれる論理」を持たせる方が自然
2026年のFeatGEO研究は、生成AIによる引用可視性を最適化する際、孤立した語句の書き換えより、文書レベルの内容特性の方が引用挙動へ強く影響したと報告しています。
同じく2026年のMind Reader研究は、クエリの背後にある潜在的なユーザー需要を捉え、その需要に対して回答に必要な推論情報をコンテンツ側でカバーすることで、生成検索内の可視性を高める方法を示しています。
これらの研究はCEP、KBF、RTBという用語を使っているわけではありません。ただ、マーケティングへ翻訳すると、
一つの文書の中で、ユーザーの状況・課題(CEP)、その状況で重要な比較軸(KBF)、自社がその条件を満たす証拠(RTB)までを一つの論理としてそろえる。
という設計がかなり自然です。
つまり、文章を機械向けに細かく切ることより、そのページを読めば「このケースでは何が重要で、なぜこの会社が候補になるのか」まで分かる状態を作る方が本筋です。
「一つのCEPにつき必ず一ページ」というルールが研究で証明されたわけではありませんが、CEP、KBF、RTBが大量のページへばらばらに分散し、関係が分からなくなるより、購買状況ごとに論理がまとまっている方が、人間にもAIにも理解しやすいと考えます。
CEP:どんな相談の時に登場するか
顧客は、必ずしもサービス名で検索しません。
- AIを導入したいが、何から試すべきか分からない
- 他社へ依頼した開発が止まっている
- 社内資料を探す時間が長い
- ベテランが辞める前に知識を残したい
- 売上はあるのに案件ごとの利益が分からない
実際、Beekleへ生成AI経由で問い合わせたお客様へ聞くと、これまで聞いた範囲では、会社名を指名して探したというより、自分たちの状況や実現したいことをAIへ相談し、その回答の中でBeekleを知ったケースが続いています。
つまり、企業側が考えるべき入口は「AI開発会社」という単語だけではなく、顧客が実際にAIへ入力する状況そのものです。
KBF:その相談では何を基準に選ぶか
同じ会社でも、CEPが変われば重要な比較軸は変わります。
「AIを小さく試したい」なら、初期費用、検証期間、評価方法、停止しやすさが重要になります。
「他社で止まった開発を立て直したい」なら、既存資料を読み解く力、要件を再整理する力、途中成果を確認できる進め方、テスト証跡が重要になります。
「社内知識をAIで検索したい」なら、検索精度だけでなく、権限、更新方法、根拠表示、誤回答時の運用が重要になります。
自社が言いたい強みではなく、その状況で顧客が何を重視するかに、自社の能力を接続します。
RTB:なぜ自社を信じてよいか
RTBは、自社がKBFを満たすと信じるための証拠です。
- 対象、期間、集計方法が明確な実績数値
- 課題、判断、対応、結果まで追える事例
- 公開可能な画面、デモ、設計、テスト結果
- 顧客の了承を得た具体的なコメント
- 第三者媒体での言及や評価
- 失敗条件、制約、向いていないケース
「実績多数」「高品質」「伴走します」は主張であって、それだけでは証拠になりません。
ブランドの信頼性を扱った研究でも、信頼性と専門性から成るブランド・クレディビリティが、比較候補に入ることや選択と関連することが示されています。
この内容について、Beekleに相談してみませんか? 何を作るべきか、どこまで費用をかけるべきか、発注前の不安を無料で整理します。チャンキングは、Webサイト運営者がLLMO対策としてやる話ではない
私はRAGを実装する側でもあるので、この話は実装感覚としてもかなり明確です。
自分でRAGを作ると分かりますが、チャンキングは基本的に情報を取得する側のアルゴリズムで行う処理です。HTMLや文書を取り込み、見出しや段落、文などを見ながら、検索やコンテキスト投入に都合のよい単位へ分割する。必要ならオーバーラップさせたり、別の粒度で索引を作ったりする。取得側が、自分のモデルや検索方式に合わせて決めます。
そのため、Webサイト運営者が「相手のAIはこう分割するかもしれない」と想像して、公開文章を300文字ごと、500文字ごとに切る必要はありません。取得側は、公開側が何も意識しなくても必要に応じて分割・解析します。
Googleも2026年の公式ガイドで、「Chunking content」をGoogle Search向けには無視してよい施策の一つとして明示しています。
Googleは、AIに理解させるためにコンテンツを小さな断片へ分ける必要はなく、同じページに複数の話題があってもシステム側でニュアンスを理解し、関連する部分をユーザーへ示せると説明しています。また、理想的なページ長もないとしています。
Google Searchには、ページ内の個別のセクションやpassageを識別し、ページの関連性を理解するPassage ranking systemもあります。
さらに、AI OverviewsやAI Mode向けに、llms.txtのような新しいAI用テキストファイル、特別なマークアップ、専用の構造化データも必要ありません。
つまり企業側がやるべきなのは、検索エンジンが内部でどう分割・解析するかを先回りして再現することではありません。
読者にとって分かりやすく、独自性があり、役に立ち、文書全体としてCEP・KBF・RTBの論理と証拠がつながっている情報を作ることです。
見出しや段落は、人間が読みやすいように普通に整理すれば十分です。
E-E-A-Tは、RTBを信頼できる形にする
Googleは、有用で信頼できるコンテンツを考える観点として、Experience、Expertise、Authoritativeness、Trustworthinessを挙げています。
LLMOとの関係は、次のように整理できます。
- CEP:どの状況で登場するか
- KBF:その状況で何を重視するか
- RTB:自社がその基準を満たす証拠
- E-E-A-T:その証拠や発信者を信頼できるか
実際の経験、専門的な説明、第三者からの認識、数字の定義、更新日、限界や例外の明示が、RTBの信頼性を支えます。
一つのページですべてを完結させるのではなく、文書を中心に根拠の束を作る
一つの文書の中ではCEP、KBF、自社の回答、主要なRTBを一貫してつなぎます。
そのうえで、詳細な事例、動画、第三者評価などは別の情報源で補強します。
- 公式サイト:サービス、条件、費用、制約の正本
- 事例:実際の課題、判断、対応、成果
- note:経営者や実務担当者の経験と判断過程
- YouTube:実物、画面、デモ、仕事の進め方
- 第三者媒体:自称ではない言及や評価
つまり、本文の論理を外部証拠で厚くするイメージです。
比較候補に入るには、会社の「選ばれる論理」を公開する
生成AIの比較候補に入るために必要なのは、AI向けの特殊な宣伝文句ではありません。
顧客がどんな状況で相談するか。その状況では何を重視して選ぶべきか。自社はどの能力で応えるか。その証拠は何か。どんな条件には向かないか。
CEP、KBF、RTBを一つの文書内でつなぎ、選ばれる理由を論理と証拠で公開する。
Google自身も、生成AI検索向けの小手先のハックより、ユーザーにとって価値があり、独自性があり、役立つコンテンツを優先するよう案内しています。
だから、LLMOで設計すべきなのはチャンクの文字数ではありません。
「このケースでは、なぜこの会社なのか」を文書全体で説明できる情報です。
参考資料
- 株式会社LANY『LLMO白書―AI時代の新たなマーケティング戦略』
- Lewis et al.(2020)Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- Aggarwal et al.(2024)GEO: Generative Engine Optimization
- Liu & Xu(2026)Think Before Writing: Feature-Level Multi-Objective Optimization for Generative Citation Visibility
- Chen et al.(2026)Mind Reader: Latent User Demand-Guided Content Optimization for Generative Search Engine
- Romaniuk & Sharp(2004)Conceptualizing and Measuring Brand Salience
- Erdem & Swait(2004)Brand Credibility, Brand Consideration, and Choice
- Google Search Central「Optimizing your website for generative AI features on Google Search」
- Google Search Central「A guide to Google Search ranking systems」
- Google Search Central「Creating helpful, reliable, people-first content」